WAS IST MACHINE LEARNING? | Die Machine Learning-Pipeline
-
WAS IST MACHINE LEARNING? | Die Machine Learning-Pipeline
-
Der Erfolg eines ML-Modells hängt wesentlich von der Datengrundlage ab. Zunächst gilt es, Fragen bezüglich der vorhandenen Daten zu klären (Sind die Daten vollständig? Welche Art Daten liegen vor? Welche Features [Merkmale] liegen bei den Daten vor?). Dies ist notwendig, damit der Datensatz vom KI-Entwickler verstanden werden kann. Für die Analyse der Datengrundlage sollte immer ein*e Experte*in aus der Anwendungsdomäne hinzugezogen werden. Nach der Analyse der Daten und Auswahl von Features müssen die Daten noch transformiert werden - textbasierte Daten werden in numerische Werte überführt, da der Computer nur mit Zahlen arbeitet.Nachdem der Datensatz analysiert und aufbereitet wurde, kann mit dem Training begonnen werden. Der erste Schritt ist hierbei die Unterteilung des Datensatzes in einen Trainings- und einen Testdatensatz. Der Trainingsdatensatz wird benutzt, um mit dem Algorithmus das Modell zu trainieren. Der Testdatensatz wiederum wird dazu verwendet, die gelernten Muster und Zusammenhänge des trainierten Modells zu testen. Es kann überprüft werden, ob der Algorithmus die Muster und Zusammenhänge verallgemeinern konnte oder diese nur für den Trainingsdatensatz „auswendig gelernt" hat.Meist werden etwa 10% des Datensatzes nicht verwendet, um zum Zwecke der Validierung als Testdatensatz eingesetzt zu werden. Zur Validierung des Modells werden verschiedene Kennzahlen ermittelt. Diese messen den Unterschied zwischen Trainings- und Testdatensatz, den so genannten Fehler und werden daher auch als Fehlermaße bezeichnet. Diese Kennzahlen bzw. Fehlermaße können zum einen genutzt werden, um verschiedene Modelle miteinander zu vergleichen. Zum anderen lassen sich mit ihnen Overfitting oder Underfitting feststellen. Beim Overfitting ist das Modell zu stark auf den Trainingsdatensatz angepasst. Die Fehlermaße beim Training sind gut, beim Testdatensatz aber nicht. Beim Underfitting wiederum ist das Modell zu wenig auf die Daten angepasst. Die Fehlermaße sind sowohl beim Training als auch beim Test nicht gut. Ein Modell hat eine gute Anpassung an die Daten, wenn die Fehlermaße beim Trainings- und beim Testdatensatz ähnlich und nicht zu groß sind.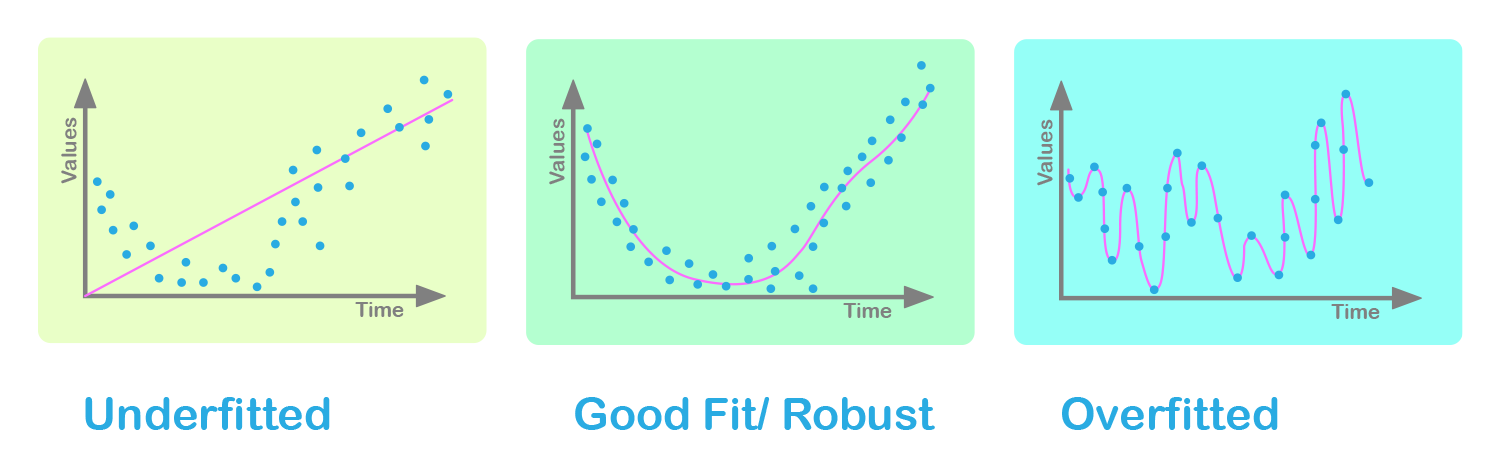
Wenn die vorherigen Schritte der Pipeline erfolgreich durchlaufen wurden, erhält man ein trainiertes Modell, das die zu lösende Problemstellung korrekt lösen kann. Dieses Modell wird nun auf neue Daten angewendet. ML-Modelle sind unflexibel gegenüber der Form der Inputdaten, diese müssen immer in der gleichen Form vorliegen. Neue Daten müssen also die gleichen Datenaufbereitungsschritte und das Training durchlaufen. Wichtig ist zudem, dass ML-Modelle fortlaufend überprüft und angepasst werden. Es kann immer sein, dass durch neue Messdaten oder -methoden, neue Richtlinien und Gesetze oder durch neue Forschungserkenntnisse in der Anwendungsdomäne die Modelle ihre ursprüngliche Aufgabe nicht mehr erfüllen können. -
Die Accuracy wird üblicherweise bei Klassifikationsproblemen eingesetzt und gibt an, wie viel Prozent der Datenpunkte korrekt vom Modell vorhergesagt bzw. klassifiziert wurden. Die Accuracy liegt zwischen 0% und 100%. Ein Wert von 0% bedeutet, dass vom Modell kein Datenpunkt in den Daten korrekt vorhergesagt bzw. klassifiziert wurde. Ein Wert von 100%, dass alle Datenpunkte korrekt klassifiziert wurden. Berechnung:
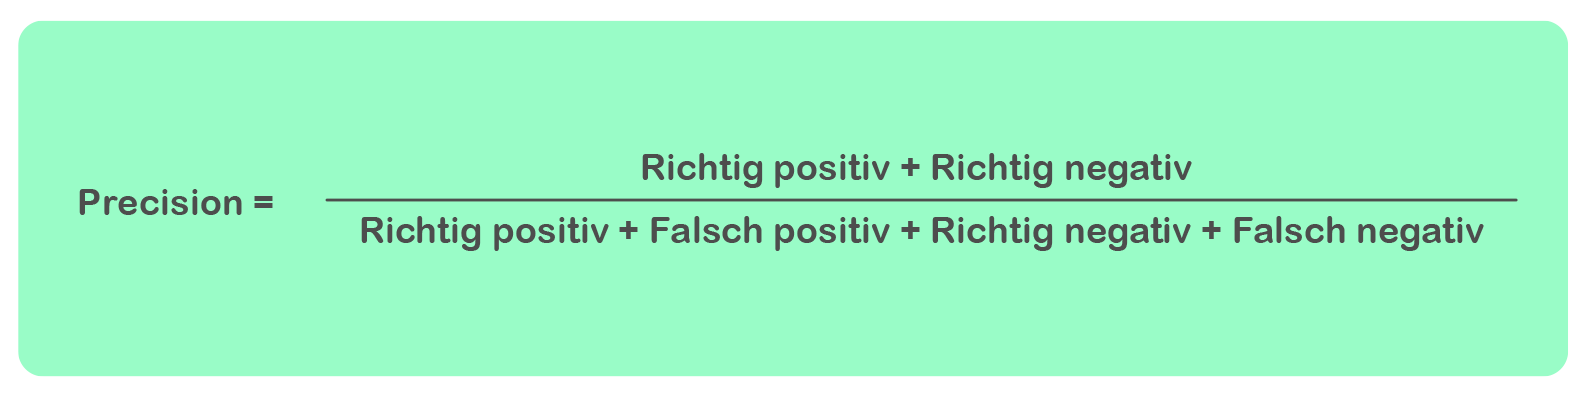
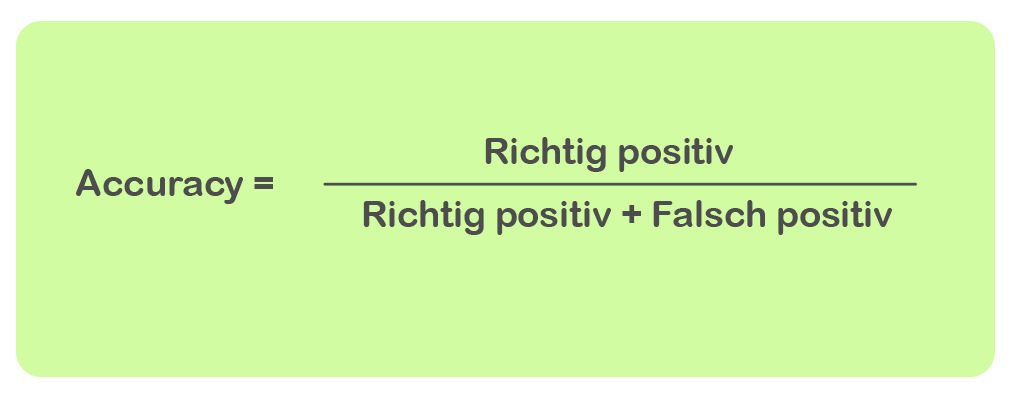 Die Precision (dt. Präzision) wird bei Klassifikationsproblemen verwendet. Sie gibt an, wie viel Prozent der vom Modell als positiv klassifizierten Datenpunkte auch tatsächlich positiv sind. Die Precision liegt zwischen 0% und 100%. Ein Wert von 0% bedeutet, dass kein Datenpunkt, der vom Modell positiv klassifiziert wird, auch tatsächlich positiv ist. Ein Wert von 100% bedeutet, dass alle Datenpunkte, die vom Modell positiv klassifiziert werden, auch tatsächlich positiv sind. Die Precision enthält jedoch keine Aussage darüber, ob alle tatsächlich positiven Datenpunkte vom Modell gefunden, d. h. auch als positiv klassifiziert werden. Übertragen auf den Kontext des Suchens von Dokumenten bedeutet Precision von 100%, dass alle Dokumente, die bei der Suche gefunden werden, zu der Suchanfrage passen und relevant sind. Es werden keine Dokumente gefunden, die nicht zu der Suchanfrage passen. Es ist aber nicht gesagt, dass die Suche alle Dokumente findet, die zu der Suche passen. Es kann sein, dass es Dokumente gibt, die zur Suchanfrage passen, aber bei der Suche nicht gefunden werden. Berechnung:
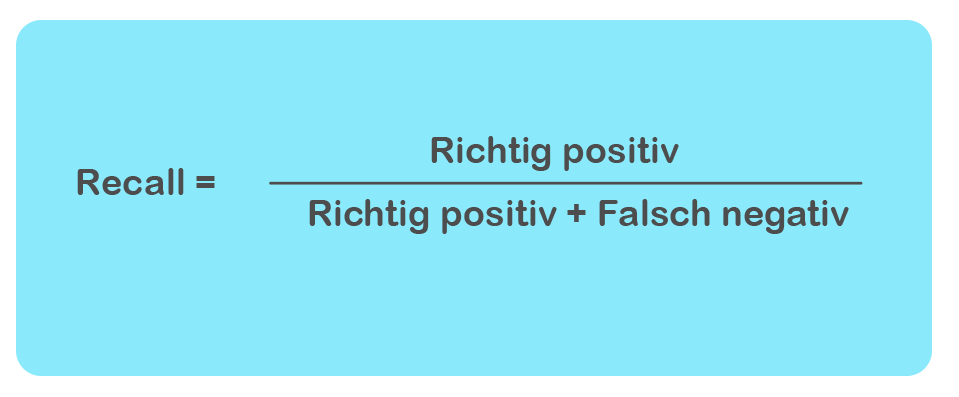
 Der Recall (dt. Ausfall) wird bei Klassifikationsproblemen verwendet. Er gibt an, wie viel Prozent der tatsächlich positiven Datenpunkte von dem Modell als positiv klassifiziert werden. Der Recall liegt zwischen 0% und 100%. Ein Wert von 0% bedeutet, dass keine der tatsächlich positiven Datenpunkte auch positiv vom Modell klassifiziert werden. Ein Wert von 100% bedeutet, dass alle tatsächlich positiven Datenpunkte vom Modell positiv klassifiziert werden. Darüber, wie viele der tatsächlich negativen Datenpunkte aber gleichzeitig vom Modell als positiv klassifiziert werden, wird keine Aussage getroffen. Bei der Suche von Dokumenten gibt ein Recall von 100% an, dass in der Suche alle passenden Dokumente gefunden werden. Er trifft aber keine Aussage darüber, wie viele irrelevante Dokumente gefunden werden. Berechnung:
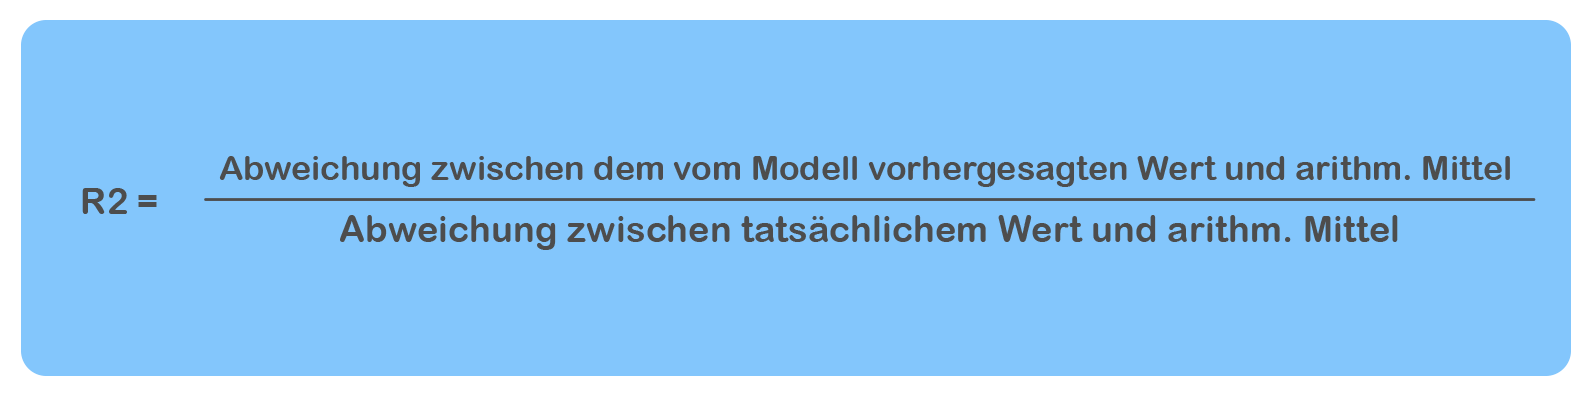
 Der R2-Score (dt. Bestimmtheitsmaß) wird bei Regressionsproblemen verwendet und gibt an, wie gut die Anpassung des Modells an die Daten ist. Der R2-Score liegt zwischen 0 und 1. Ein Wert von 0 bedeutet, dass keine Anpassung des Modells an die Daten vorliegt; das Modell ist nicht geeignet. Ein Wert von 1 bedeutet, dass eine perfekte Anpassung vorliegt. Der R2-Score gibt an, wie viel der Abweichung zwischen dem tatsächlichem Wert und dem arithmetischen Mittel von dem Modell erklärt werden kann. Berechnung:
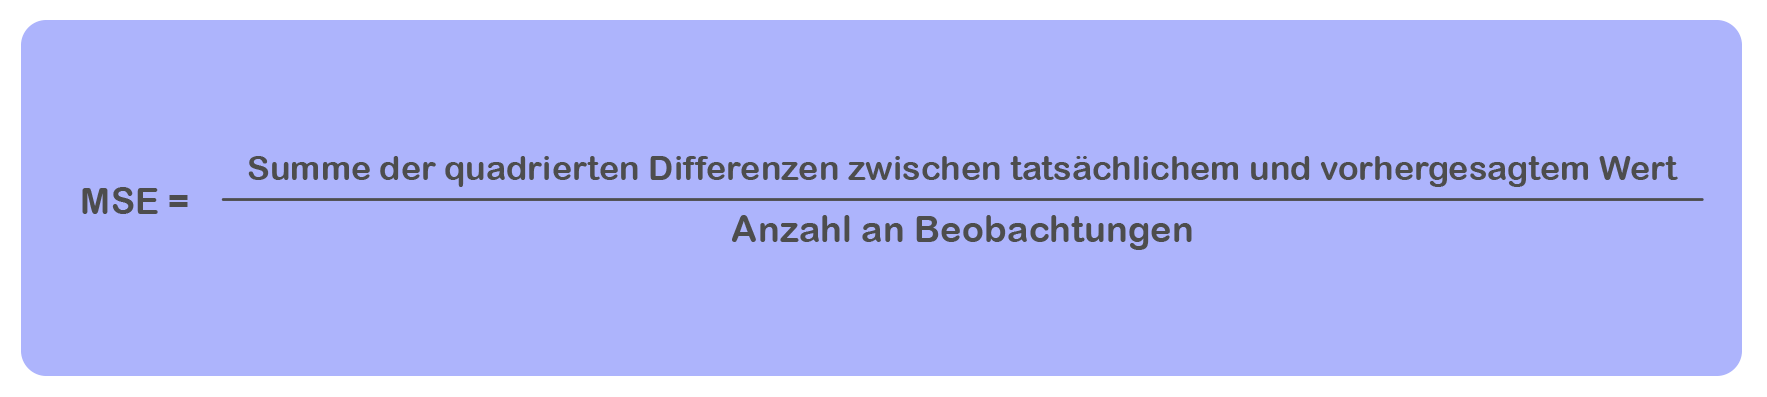
 Der Mean Squared Error (dt. Mittlere quadratische Abweichung) wird bei Regressionsproblemen verwendet und gibt an, wie groß der Unterschied zwischen dem tatsächlichen Wert und der Modellvorhersage aller Datenpunkte im Mittel ist. Ein weiteres Fehlermaß, das diesen Unterschied misst, ist der Mean Absolute Error (dt. Mittlere absolute Abweichung). Der Mean Squared Error (MSE) ist immer größer als null. Nach oben ist er nicht begrenzt. Ein Modell wird als umso besser angesehen, je geringer der MSE ist. Das gleiche gilt für den Mean Absolute Error (MAE). Berechnung:
-
Teilnehmer/innen müssenAls erledigt kennzeichnen
Themenbereich bearbeitet!