EXKURS: ChatGPT
-
EXKURS: ChatGPT
-
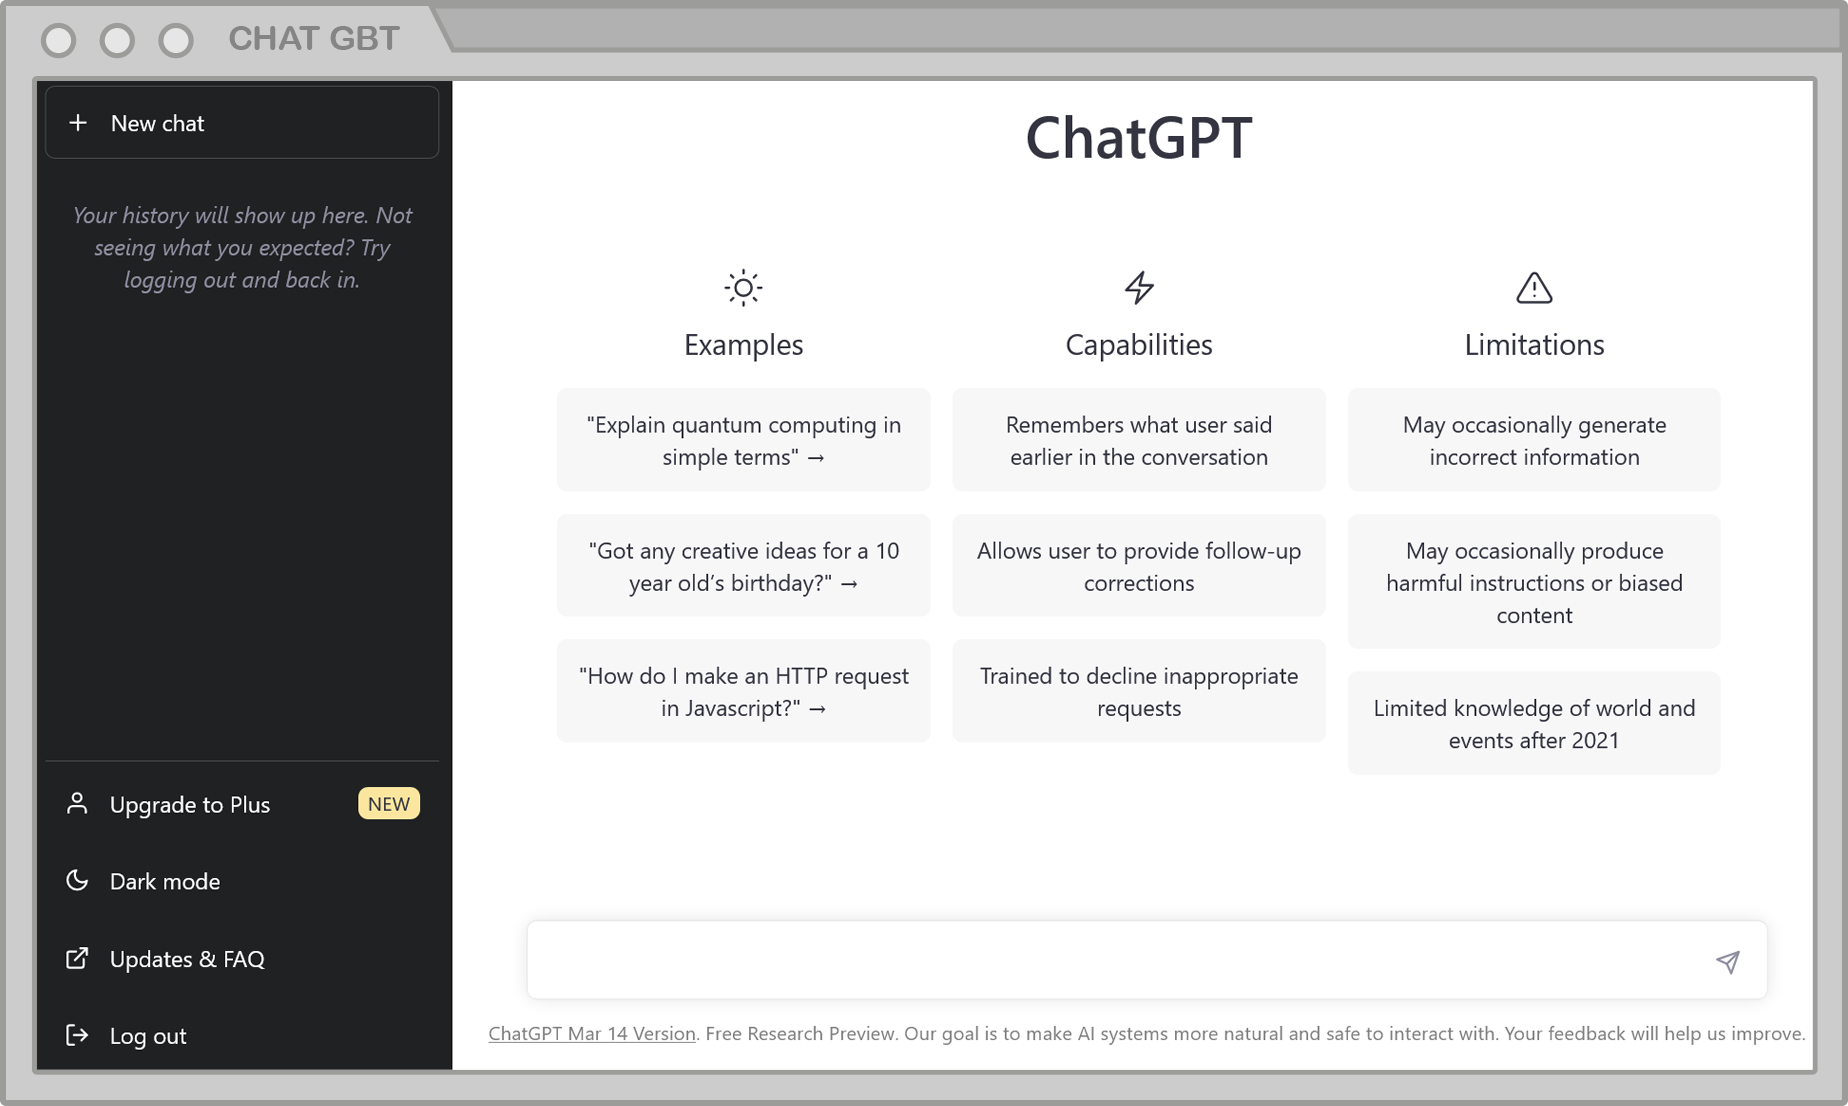
Abb.: Startseite von ChatGPT im März 2023.
-
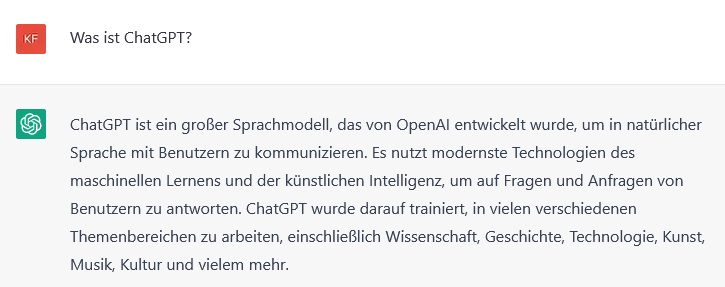
Wenn man ChatGPT die Frage stellt, was ChatGPT ist, so sieht die Antwort in diesem Fall folgendermaßen aus:
-
Vielleicht fällt dir bei diesem Beispiel auf, dass das Programm bei der Beantwortung der Frage durchaus (noch) grammatikalische Fehler macht.
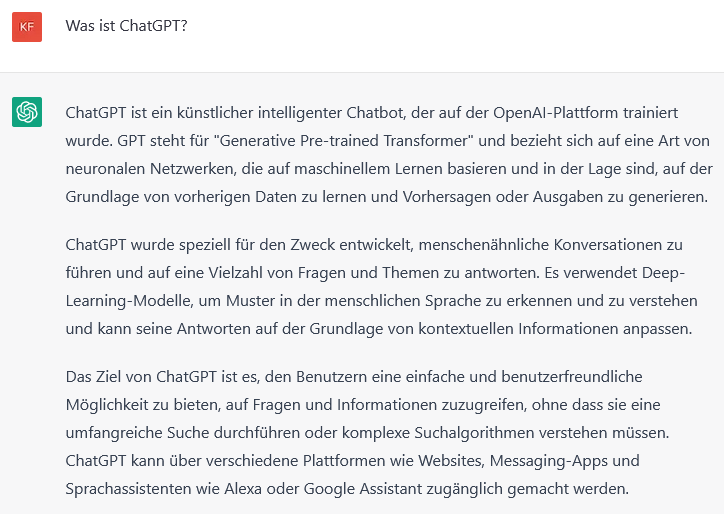
Wenn du die gleiche Frage kurze Zeit später ein zweites Mal stellst, kann die Antwort ganz anders aussehen:
-
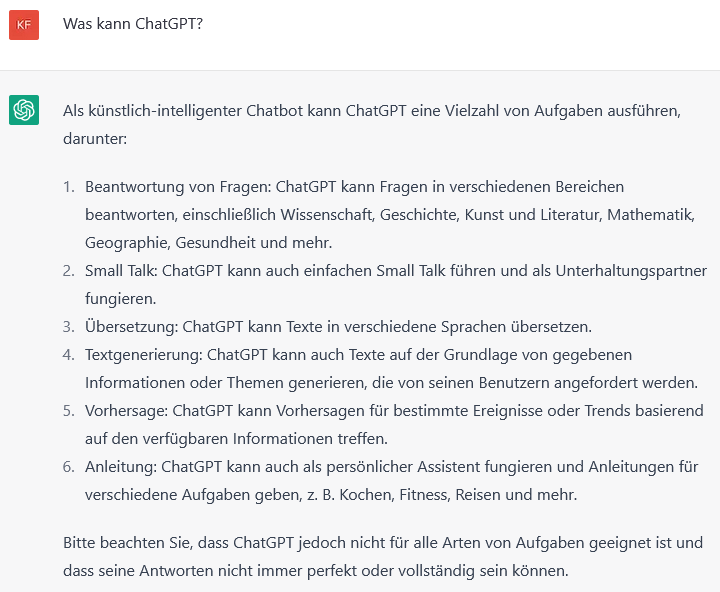
Eine ähnlich formulierte Antwort gibt dir das Programm auf die Frage, was es denn kann:
-
 MERKE: ChatGPT ist ein Prototyp eines Chatbots, der auf maschinellem Lernen und künstlicher Intelligenz beruht.
-
 ChatGPT wird seit seiner Veröffentlichung stetig weiterentwickelt und optimiert.
Die derzeitige Version wurde in mehreren Phasen trainiert:
1. Phase: Die Grundlage von ChatGPT ist das Sprachmodell PGT-3,5. Das Training erfolgte durch selbstüberwachtes Lernen, es ging hierbei darum, das nächste Wort eines Textausschnitts vorherzusagen.
Diese erste Phase wird als Pre-Training bezeichnet.2. Phase: Als nächster Schritt wurde das Sprachmodell durch überwachtes Lernen auf die eigentliche Aufgabe eingestellt: Antworten auf vorher gestellte Fragen zu generieren. Diese zweite Phase wird als Fine-Tuning bezeichnet.
Abb.: Roboter.
3. Phase: Das Sprachmodell wurde im folgenden Schritt durch verstärkendes Lernen weiter optimiert. Ein weiteres Modell, das sogenannte "Reward-Model" wurde mit überwachtem Lernen trainiert, um gegebene Antworten qualitativ in Form einer Rangliste zu bewerten. Als letztes wurde ein weiterer Algorithmus genutzt - der "Proximal-Policy-Optimization-Algorithmus" -, der das Reward-Model als die zu maximierende Belohnungsfunktion einsetzte.
-
 ChatGPT wurde von dessen Entwickler*innen mit Schutzmechanismen versehen, sodass falsche und schädliche (z. B. rassistische, sexistische oder nichtlegale) Antworten vermieden werden sollen.
-
Klick hier
 Wie kann ich ChatGPT nutzen?
Die momentan aktuelle Version (Frühjahr 2023) ist frei zugänglich und über den Webbrowser nutzbar, nachdem du dich mit deiner E-Mail-Adresse und Telefonnummer registriert hast. Es gibt auch eine kostenpflichtige Version, die bei hoher Nachfrage eine schnellere Antwortgeschwindigkeit und bessere Zugänglichkeit bietet.
-
Klick hier
 Wofür kann ich ChatGPT nutzen?
- Um Texte schreiben zu lassen (du kannst ChatGPT bitten, einen Text über ein bestimmtes Thema zu verfassen.)
- Um Texte zusammenfassen zu lassen (indem du einen Text oder eine URL reinkopierst und ChatGPT bittest, die wichtigsten Punkte zusammenzufassen oder den Text in kurze Stichpunkte umzuschreiben)
- Um Texte umschreiben zu lassen (du kannst einen Text reinkopieren und ChatGPT bitten, den Text einfacher und kürzer auszugeben)
- Um Texte übersetzen zu lassen (Text reinkopieren und in eine andere Sprache übersetzen lassen)
- Um Texte analysieren zu lassen (ChatGPT kann einen Text auf den Ton, die Stimmung, die Schlüsselwörter und mehr analysieren)
- Um Texte vervollständigen zu lassen (ChatGPT kann einen angefangenen Text zu Ende schreiben, wobei es sich am bisherigen Schreibstil des Textes orientiert)
- Um Texte klassifizieren zu lassen (ChatGPT kann einen Text zu einer bestimmten Textkategorie zuordnen, z. B. Nachrichten oder Rezepte)
-
Klick hier
 Kann ich den Antworten von ChatGPT trauen?
Wenn es um wichtige Informationen geht, solltest du den Antworten von ChatGPT nicht einfach blind vertrauen, sondern sie lieber noch einmal überprüfen. Hintergrund ist, dass das Sprachmodell viele Jahre lang trainiert wurde, aber einige der zugrundeliegenden Informationen nicht mehr aktuell sind. Ein weiteres Problem ist, dass die gestellte Frage von ChatGPT missverstanden werden kann und dann falsche Antworten generiert werden. Einfache Wissensfragen werden aber in der Regel zuverlässig beantwortet.
-
 Das Sprachmodell von ChatGPT wurde mit echten Texten trainiert, gibt aber in der Regel keine Quellen an. Es kann also vorkommen, dass die von ChatGPT produzierten Texte als Plagiate angesehen werden könnten, wenn du sie unter deinem Namen verwendest. Du solltest dies daher immer prüfen und gegebenenfalls darauf hinweisen, dass dein Text mithilfe einer künstlichen Intelligenz geschrieben wurde.